

Bardzo często można natrafić na witryny zawierające zestawienia katalogów, precli, blogów dofollow czy proxy. Czasem chcielibyśmy pozyskać z takiej witryny same odnośniki. Przy kilkuset podstronach, na każdej 20-100 odnośników kopiowanie ręczne jest nierealne… chyba że ktoś ma sporo wolnego czasu i cierpliwości. Klikanie, kopiuj, wklej z wykorzystaniem notatnika ech… to nie dla nas. Znam lepszą metodę.
Do szybkiego pozyskiwania linków z odwiedzanych witryn posłuży nam przeglądarka Google Chrome wyposażona w dodatek Scraper.
Google Chrome Scraper to niepozorne narzędzie, którego celem jest pozyskiwanie konkretnych danych ze stron internetowych oraz eksport informacji do arkusza kalkulacyjnego Google Docs. Do obróbki danych domyślnie wykorzystuje wyrażenia XPath (XML Path Language), których złożoność jest o wiele mniej skomplikowana aniżeli tradycyjne wyrażenia regularne. Nie oznacza to, że XPath cierpi z powodu braku funkcjonalności, wręcz przeciwnie, jeśli chodzi o filtrowanie danych jest rewelacyjne. Nie wiem jak u Was z tym jest, ale osobiście mam odczucie, iż z pamięci o wiele łatwiej wpisać selektory XPath, niż klasyczne regułki przynależne do wyrażeń regularnych.
Uruchamiamy przeglądarkę Chrome z zainstalowanym dodatkiem Scraper i zaczynamy zabawę…
Listy katalogów, wyciąganie URL wyrażeniami XPath
Wpierw zajmiemy się katalogami. Przejdę od razu do przykładów. Pierwsze zestawienie, chyba jedno z popularniejszych www.katalogiseo.info
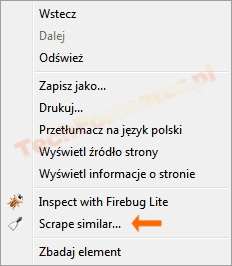
Wchodzimy na stronę, wywołujemy menu kontekstowe i wybieramy Scrape similar. Normalnie powinniśmy zaznaczyć wybrany tekst (link) i dopiero wtedy dokonać wyboru opcji, w przypadku zaawansowanego scrapingu to jest zbędne, albowiem regułkę i tak będzie trzeba zdefiniować od zera.
Mamy wywołany moduł Scraper, w lewej części okna znajdziemy pole XPath Reference, w którym to należy wpisać wyrażenie służące do wydobywania linków ze strony.
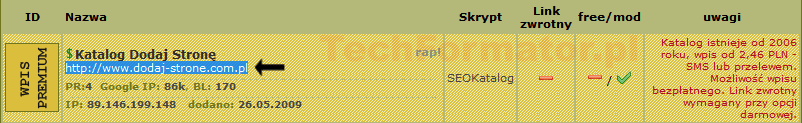
Aby zbudować wyrażenie warto przejść do kodu źródłowego i zobaczyć co w trawie piszczy. Do inspekcji danego fragmentu użyjemy Firebug. Zaznaczamy pierwsze od góry hiperłącze do katalogu i z menu kontekstowego wybieramy Inspect with Firebug Lite.
Interesuje nas hierarchia znaczników, co w czym się znajduje, co jaką klasą jest oznaczone. To pozwoli sprecyzować, który element witryny należy wyodrębnić.
Dla www.katalogiseo.info przykładowe wyrażenie XPath ma postać…
//table/tbody/tr/td/a[@class='broken']
Na zrzucie ekranu kolorem żółtym zaznaczyłem, które elementy zostały wykorzystane do zbudowania wyrażenia. Nie będę opisywał schematów reguł i sposobów budowania wyrażeń, tego typu informacje znajdziecie w dokumentacji XPath.
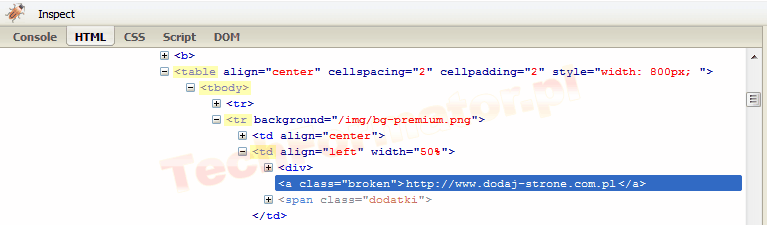
Teoretycznie gdybym ograniczył się do wskazania /a[@class=’broken’] na wyjściu także otrzymam zestaw linków, natomiast wyznaję zasadę, czym precyzyjniej tym lepiej.
Po zbudowaniu wyrażenia wprowadzamy go w polu XPath Reference, po czym klikamy Scrape lub wciskamy klawisz ENTER. Wynikiem polecenia jest lista adresów URL.
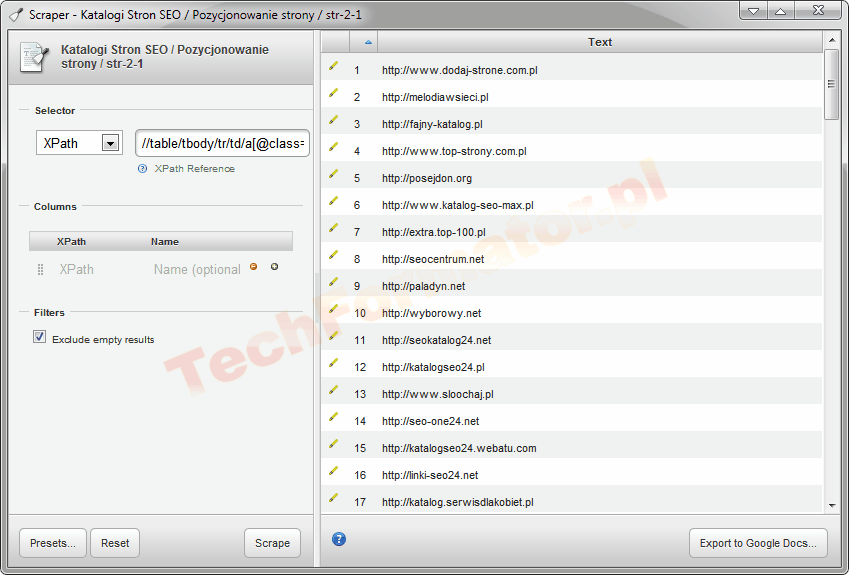
Teraz najciekawsza opcja. W prawym dolnym rogu istnieje przycisk oznaczony Export to Google Docs. Wszelkie przechwycone dane możemy łatwo zapisać do skoroszytu.
Dodatkową zaletą wtyczki jest zapamiętywanie wyrażeń (Presets). Zapisanie schematów bardzo pomaga podczas pobierania informacji z wielu stron/podstron.
W przypadku użycia funkcji CTRL+A i CTRL+V, po wklejeniu odnośników do notatnika powstanie lista numerowana, zatem aby uzyskać czyste informacje będzie trzeba obrobić dane wyrażeniami regularnymi.
Kilka innych przykładowych patternów XPath do wykorzystania:
- www.katalogi.net.pl: //table/tbody/tr/td/a[@class=’tytul’]/@href
- dobre-katalogi.pl: //strong/a/@href
- autospis.pl: //div/table/tbody/tr/td/a[@class=’nazwak’]/@href
- www.moje-katalogi.pl: //table/tbody/tr/td/table/tbody/tr/td/font[@color=’#0000FF’]
Pozyskiwanie linków z wyników wyszukiwania
Metodę można zastosować dla wyników wyszukiwania. Przykładowe wyrażenie XPath pobierające z Google adresy URL:
//div/div/ol/li/div/h3[@class='r']/a/@href
Dla wyszukiwarki Bing…
//div[@class='sb_tlst']/h3/a/@href
Dla Blekko…
//li/div/h2[@class='title']/a/@href
Czasem aby pobrać pewne informacje ze strony nie ma sensu stosować wyspecjalizowanych automatów. Niniejszą metodę wyodrębniania odnośników przedstawiłem jako ciekawostkę.




Nie znałem dodatku, ale świetnie się nadaje do budowania list katalogów.
Świetny art. Dzięki.
Korzystam z dodatku już jakiś czas i najbardziej podoba mi się funkcja eksportu do Google Docs, bo tam w chmurze mam wszelkie pliki.
Jedynie co to wiele osób może mieć problem z konfiguracją dodatku, ale tak jest idealne.
Dopiero jakiś czas jestem szczęśliwym użytkownikiem Chrome i coraz bardziej mnie to cieszy. Dodatek jak najbardziej się przyda, świetna sprawa. W ogóle widziałem kilka innych ciekawych artykułów, które jutro na spokojnie będę musiał przeczytać.
Dzięki, pozdrawiam.
Dodatki XPath do Firefox również są więc porada jest uniwersalna. Natomiast Scraper dla Google Chrome jest na tyle funkcjonalny, że postanowiłem opisać ten wariant.
Mam świadomość że do Firefoksa również są tego rodzaju dodatki, aczkolwiek nie tak dawno przesiadłem się na Chrome ze względu na dziwny problem z wydajnością FF. Do tego czasu głównie korzystałem właśnie z FF no a reszta przeglądarek okazjonalnie. Odkąd jednak w FF zaczęły się problemy to zmieniłem przeglądarkę (i dotychczasowe przyzwyczajenie) bo bardzo cenię sobie komfort pracy.
Pozdrawiam i idę przejrzeć pozostałe artykuły.
To prawda, nawet optymalizacja Firefox nic już nie pomaga. Ostatnio proces firefox.exe zjadł u mnie prawie 2 giga ramu musiałem ubić żeby nie wykończyć systemu. Coraz nowsze wersje wychodzą a wciąż nie rozwiązano problemu. Dlatego podobnie jak Ty coraz częściej korzystam z Chrome – jedyna słuszna alternatywa dla pozycjonerów. Opera byłaby dobra ale za mało skryptów (dodatków) SEO jest dla niej.
Super , nie miałem pojęcia o tym dodatku , serdeczne dzięki za poradnik .Pozdrawiam .
Denis , możesz napisać coś więcej o konfiguracji dodatku ?Z góry dzięki .
Zainstalowałem dodatek i prawdę mówiąc nie widzę żadnej specjalnej konfiguracji, która mogłaby komuś sprawić problemy.
A swoją drogą dodatek bardzo ciekawy. Właśnie sobie wyciągnąłem z jednej stronki około 2 tys. adresików. Super! 🙂
Czy jest jakieś darmowe albo płatne narzędzie, które by pozwalało wyciągać tekst umieszczony w danej klasie na stronie? Np. mam listę 50 podstron z jednego serwisu i z każdej z nich chcę wyciągnąć krótki fragment tekstu, który jest umieszczony zawsze w divie o tej samej klasie. Czy można zrobić to jakoś automatycznie?
Pewnie że da się 🙂
Darmowego automatu nie znam dlatego musiałem wysilić się i zrobić swój program, który by automatycznie wyciągał ze stron pewne rzeczy bazując na wyrażeniach XPath. Programik prosty lecz piekielnie skuteczny, wystarczy mieć footprint xpath i można wszystko wyciągnąć.
Być może w najbliższym czasie udostępnię program wszystkim lajkowiczom ale w okrojonej wersji bez trybu automatycznego.
Wersję rozszerzoną (automat) mogę udostępnić wyłącznie odpłatnie lub w zamian za kilka multikodów do katalogów.
Ciekawy programik tylko jest jeden problem. A mianowicie przeczytajcie uprawnienia jakimi dysponuje program czy dodatek w waszym systemie. cyt „…możliwe pobieranie danych ze wszystkich twoich witryn”. Łącznie z hasłami i innymi rzeczami, których pilnujecie. Dlatego jest free. A za inne tego typu płacimy ;o)
@Mayer, a skąd wiesz że ma dostęp? Sprawdzałeś jak plugin komunikuje się z przeglądarką?
W Androidzie pełno masz takich aplikacji, które instalujesz a które wymagają podwyższonych uprawnień i nikt z tego wielkiego problemu nie robi.
Podany pattern XPath do wykorzystania w Serpach Googlowych coś mi teraz w Chromie nie działa (a dotychczas działał elegancko). W tej chwili poprawnie wyciąga linki dla:
//h3[@class=’r’]/a/@href
Tak poza tym wielki szacun!
Teraz ten dodatek nazywa się Data Miner